所要5分 / 図1枚・表1枚でわかる レベル: ★☆☆ 初心者向け
⏱ 30秒でわかる要約 — 初心者向け
- 結論: エヌビディアBlackwellラック当たり120kW液冷とギガワット電力網がAIファクトリーの覇権を変える
- ポイント1: Blackwellラック当たり120kW液体冷却、ギガワット級電力網がデータセンターのボトルネック
- ポイント2: 電力・冷却インフラがAI半導体需要の次のボトルネック
- 次の一手: 次四半期のデータセンター電力・冷却設備投資ガイダンスを確認
Blackwell=要点GPU / 液冷=要点ギガワット=GW — 本文中の 青い点線 にカーソルを当てると説明が出ます。
〜 チップ単体から電力・冷却の垂直統合へ、AIデータセンターのボトルネックを支配する75%粗利のビジネスモデル 〜
項目 / 内容 概要
| 項目 | 内容 |
|---|---|
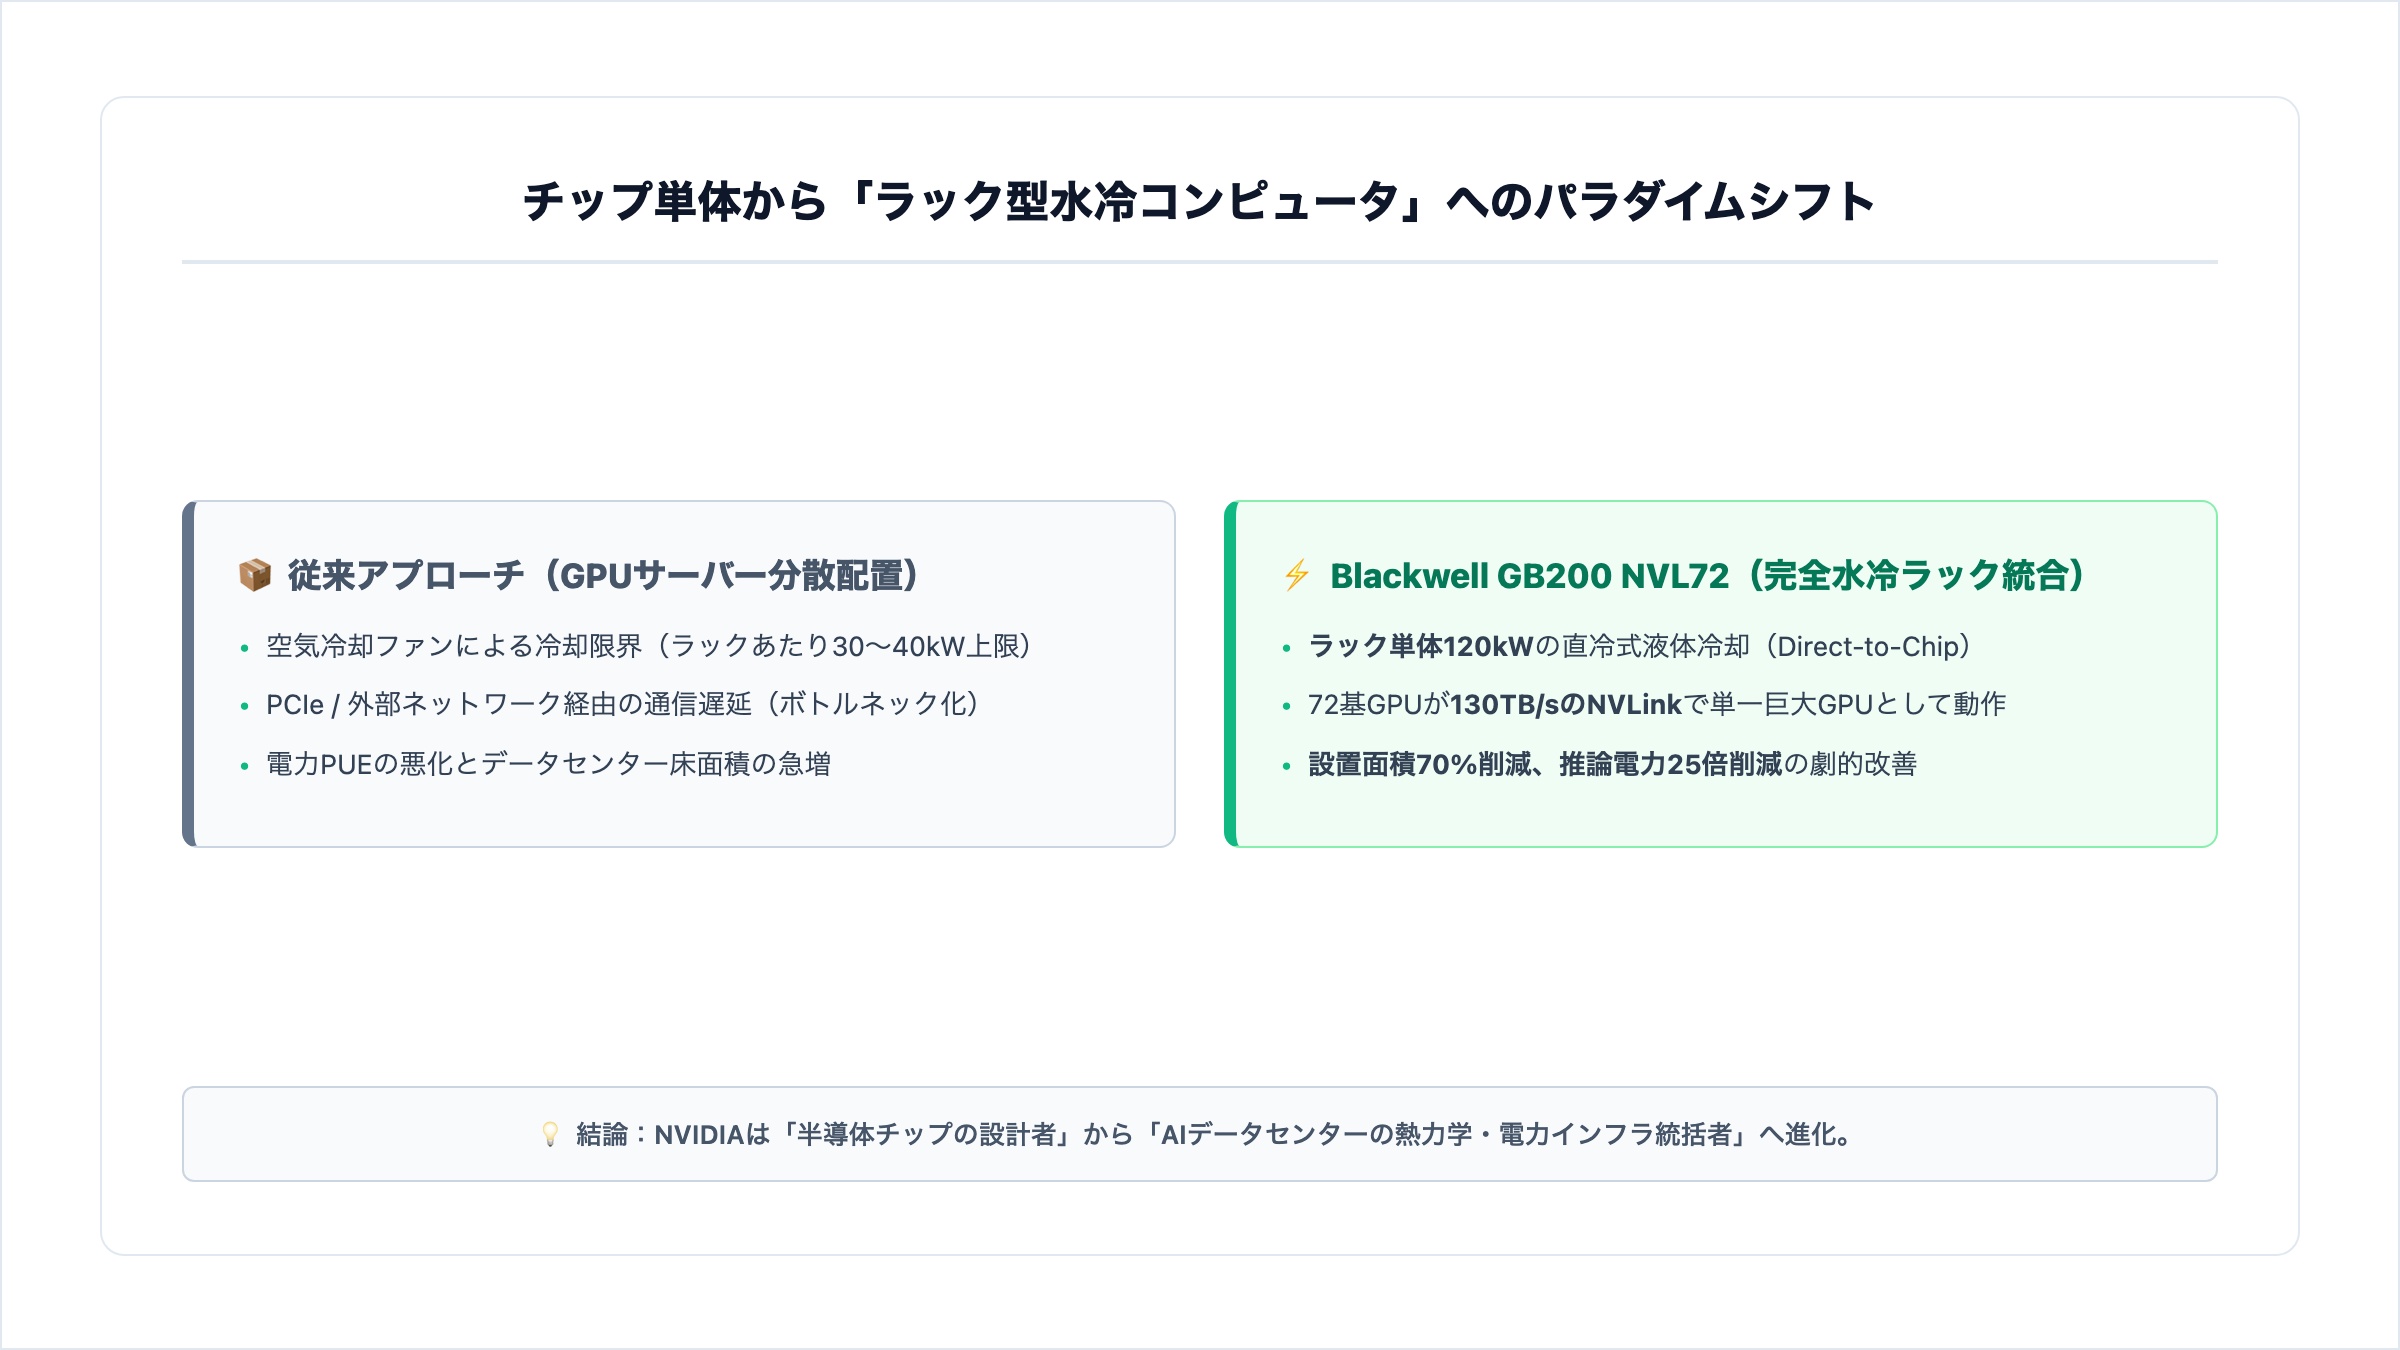
| アーキテクチャの進化 | 単体GPUから72基のGPUを直結した水冷ラックシステム「GB200 NVL72」へ移行。ラック単体で120kWの超高密度電力を消費 |
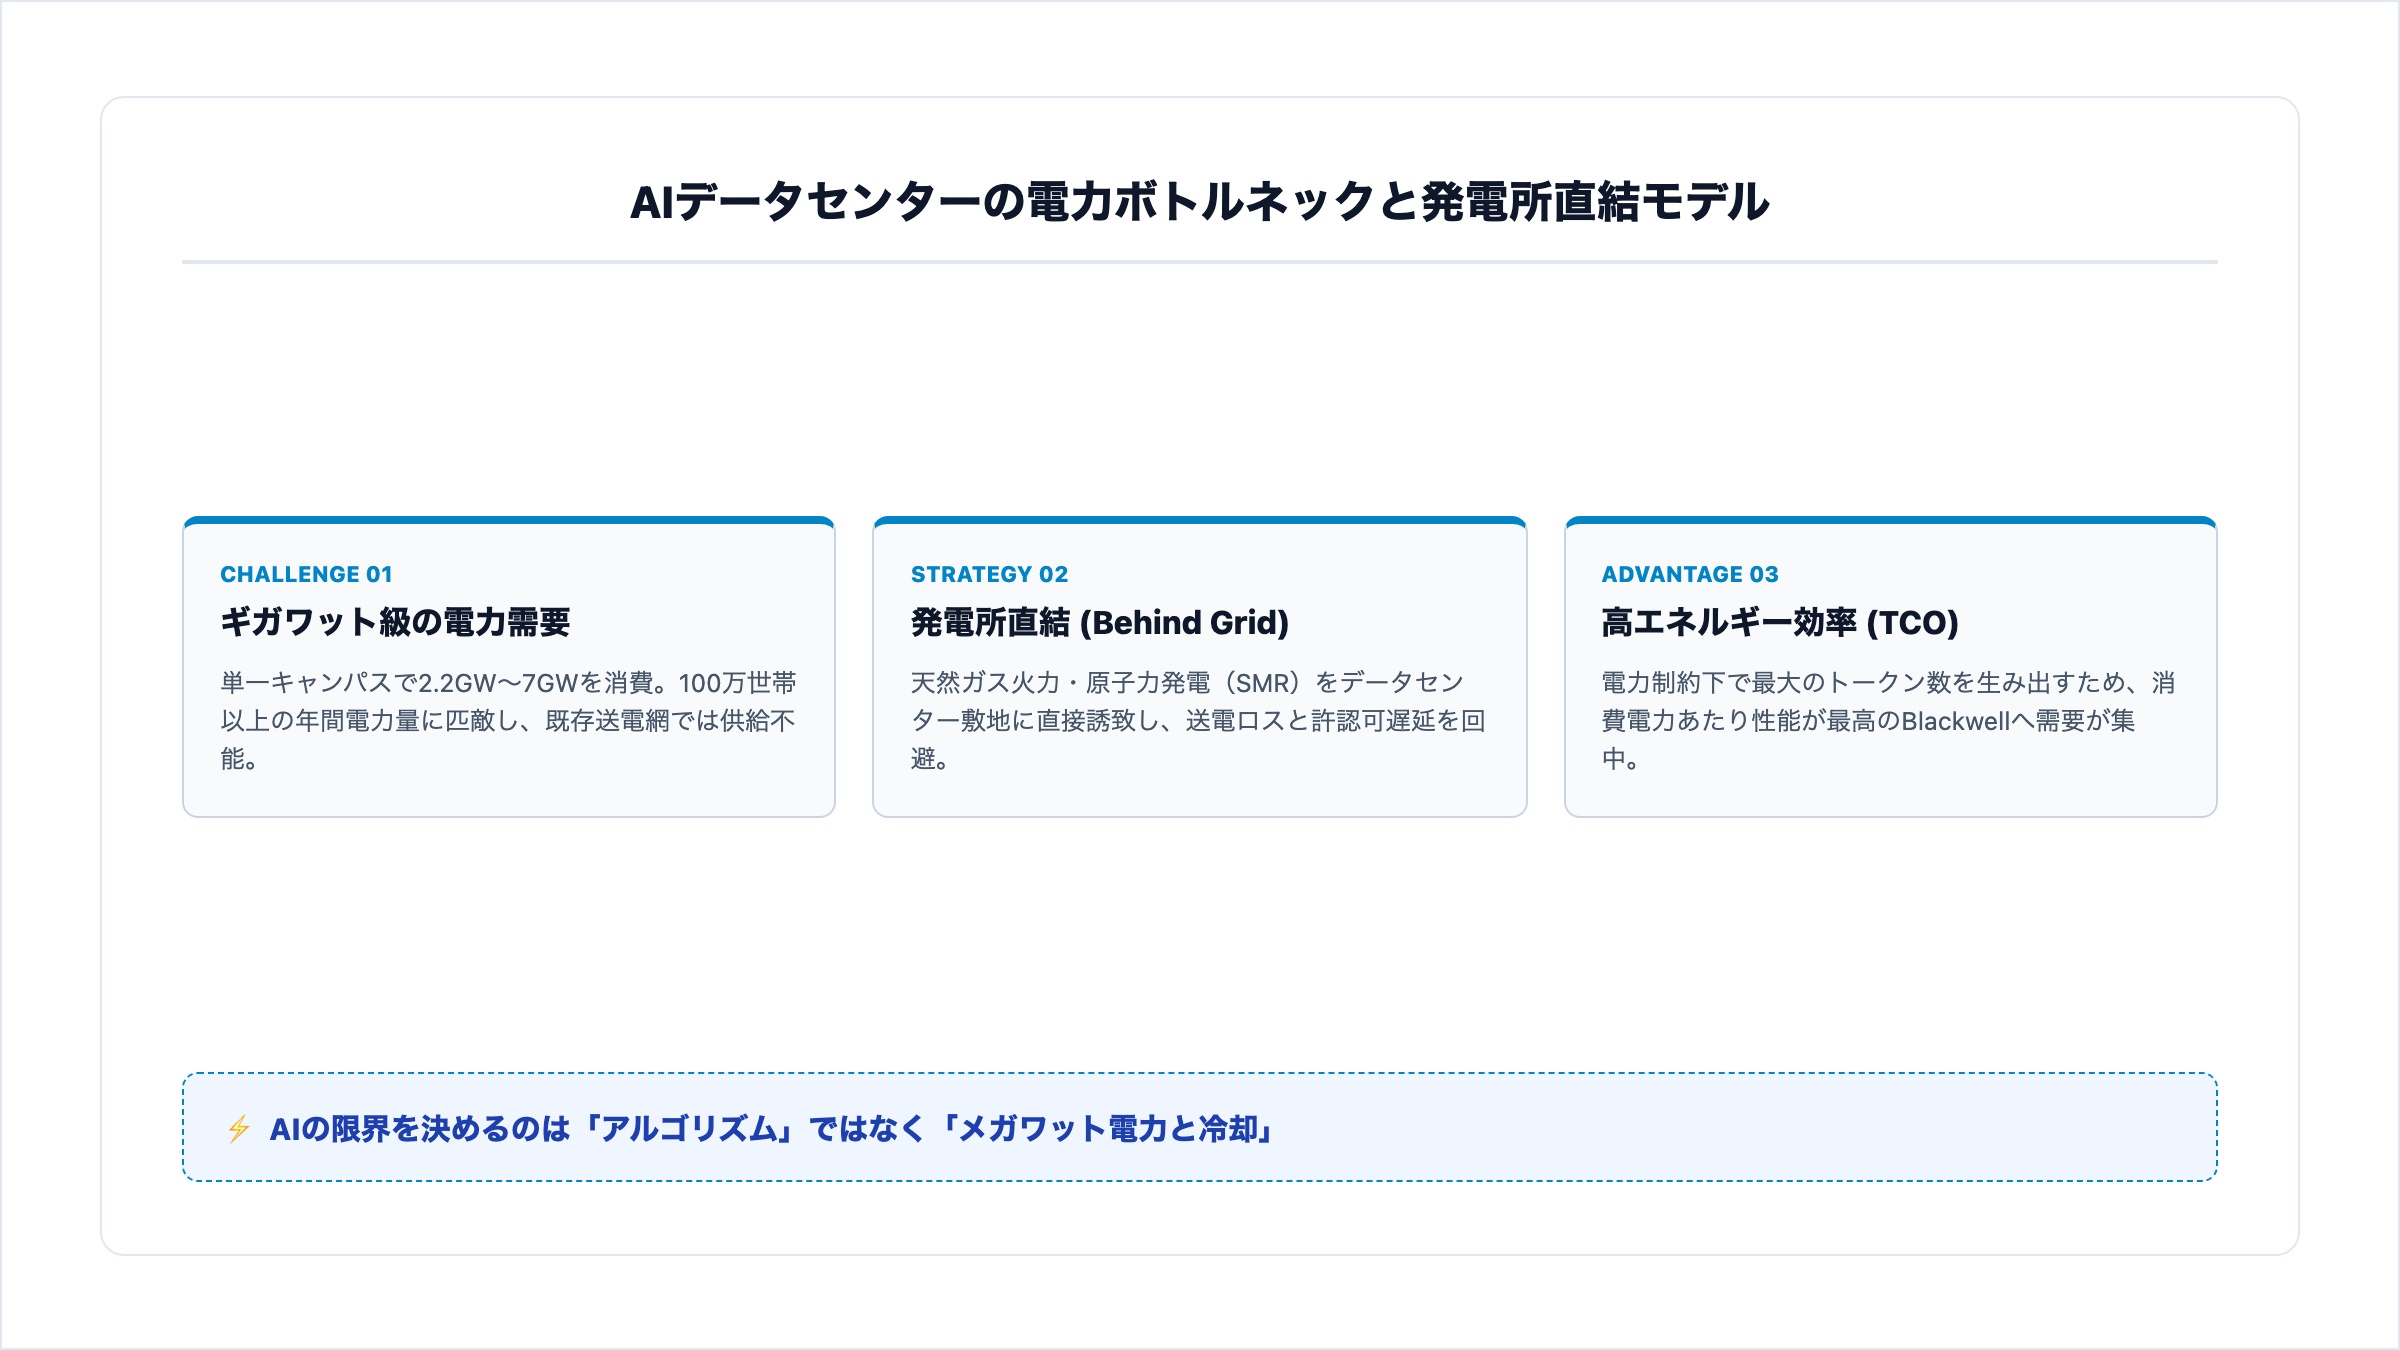
| データセンターの電力危機 | 最新AIクラスタ単体で2.2GW〜7GW(原発2〜7基分、100万世帯超の電力)を消費し、AI投資のボトルネックが半導体から「電力と冷却」へ移行 |
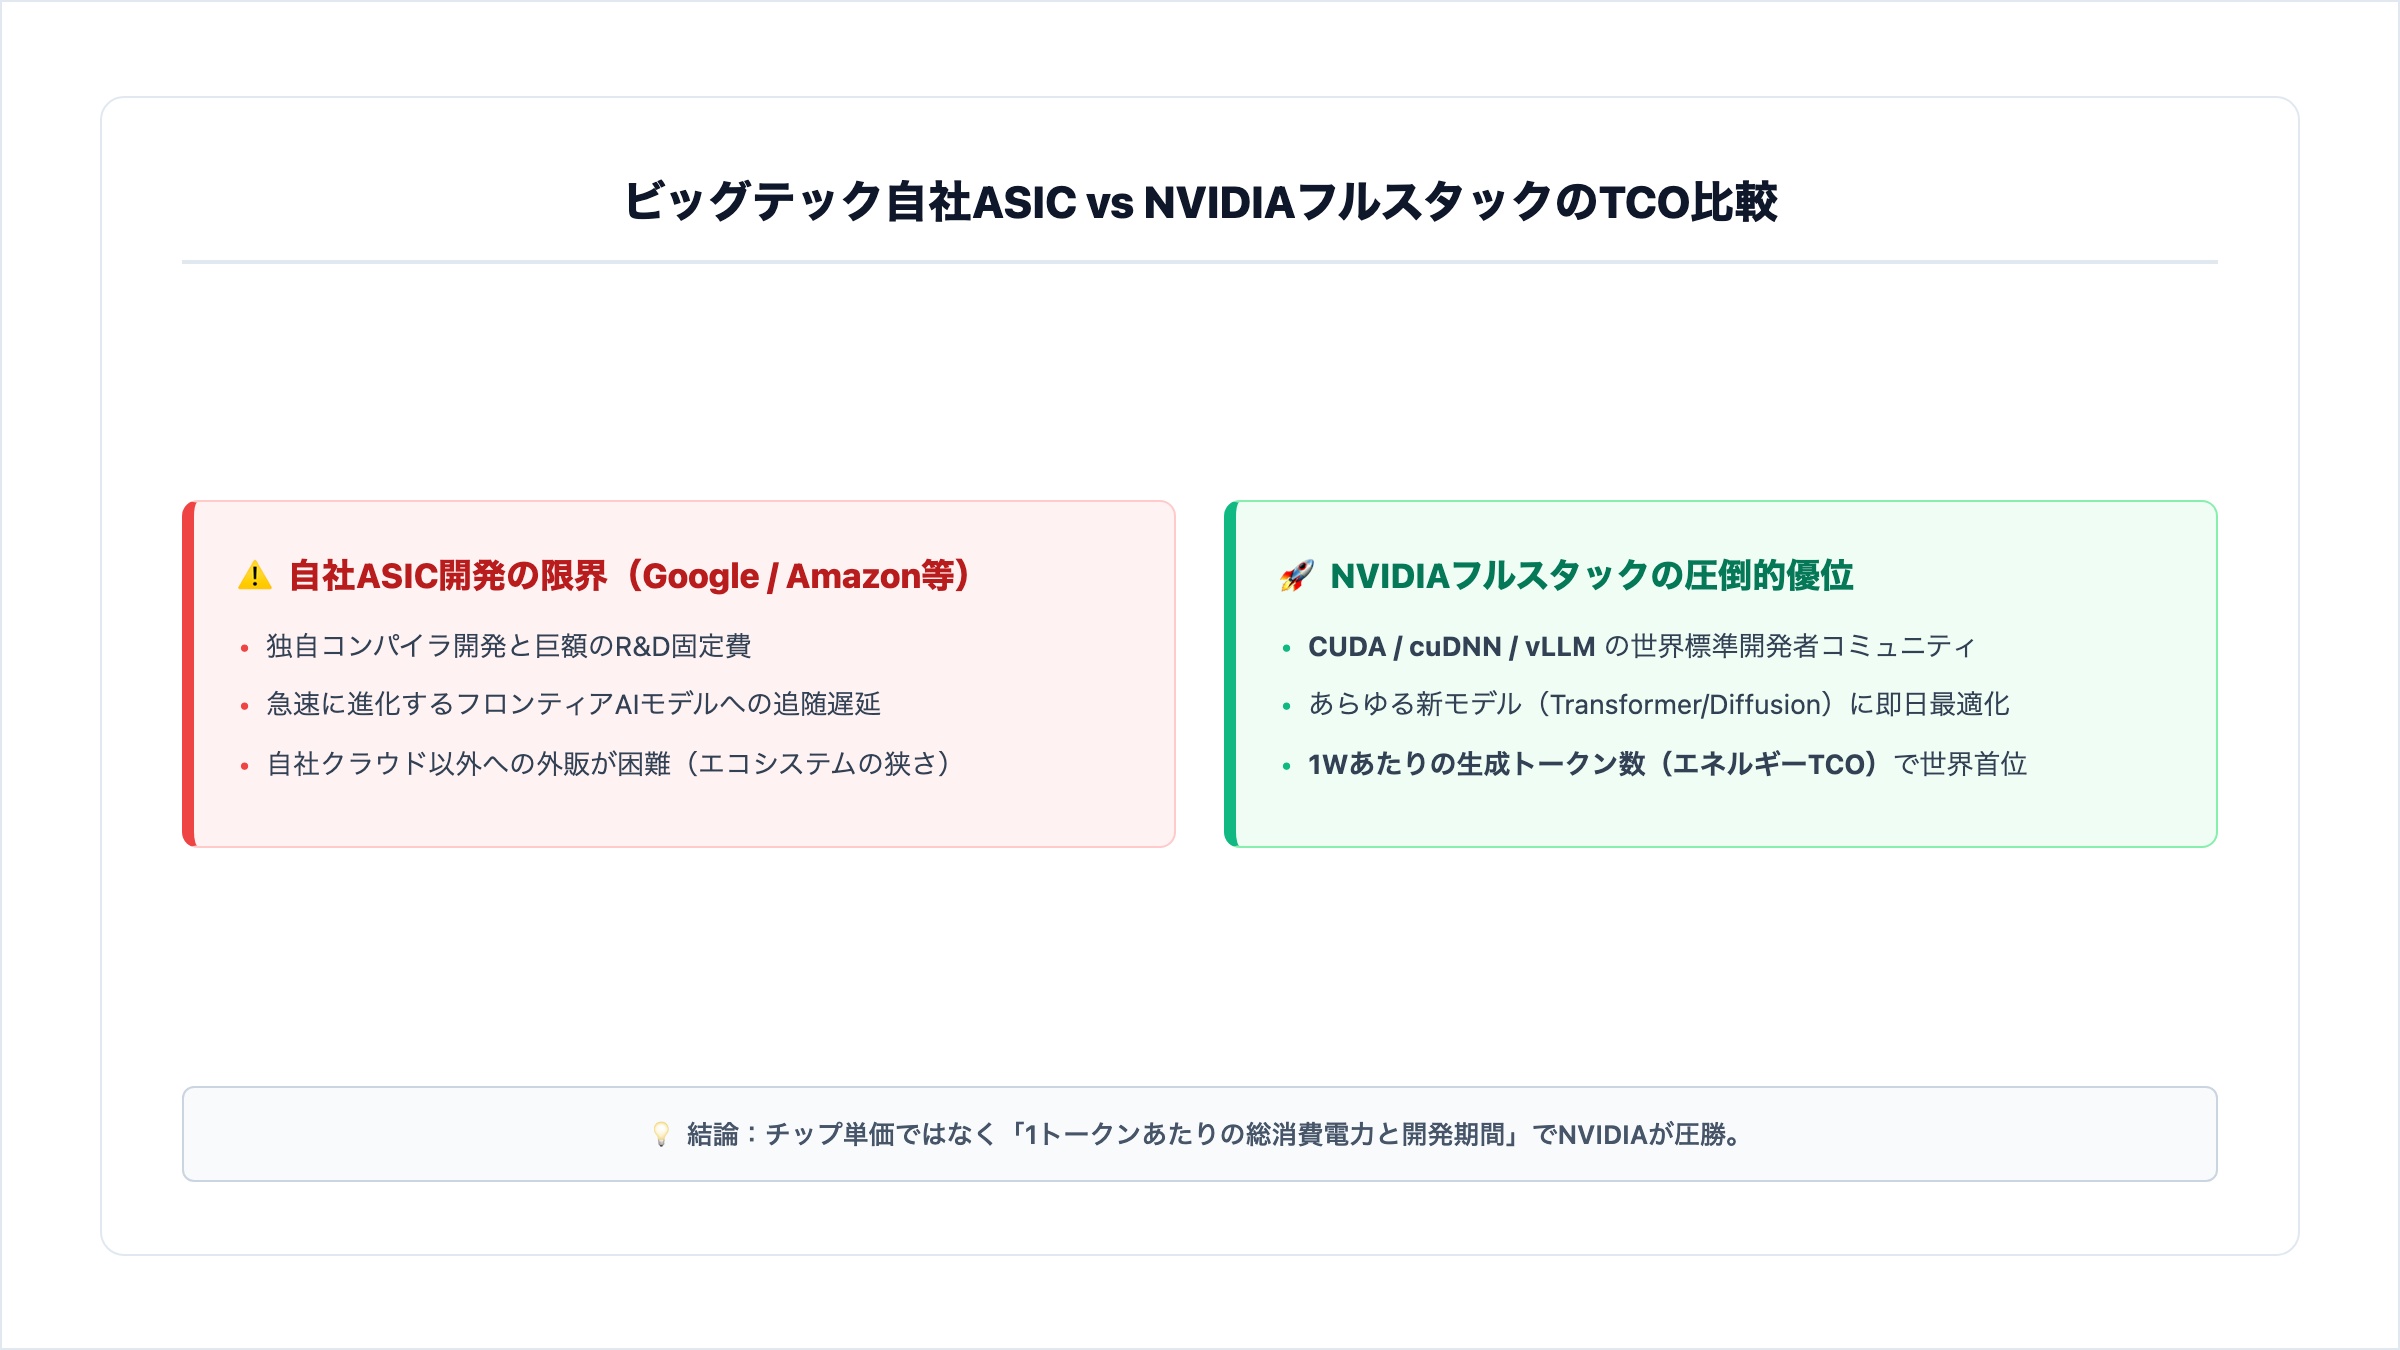
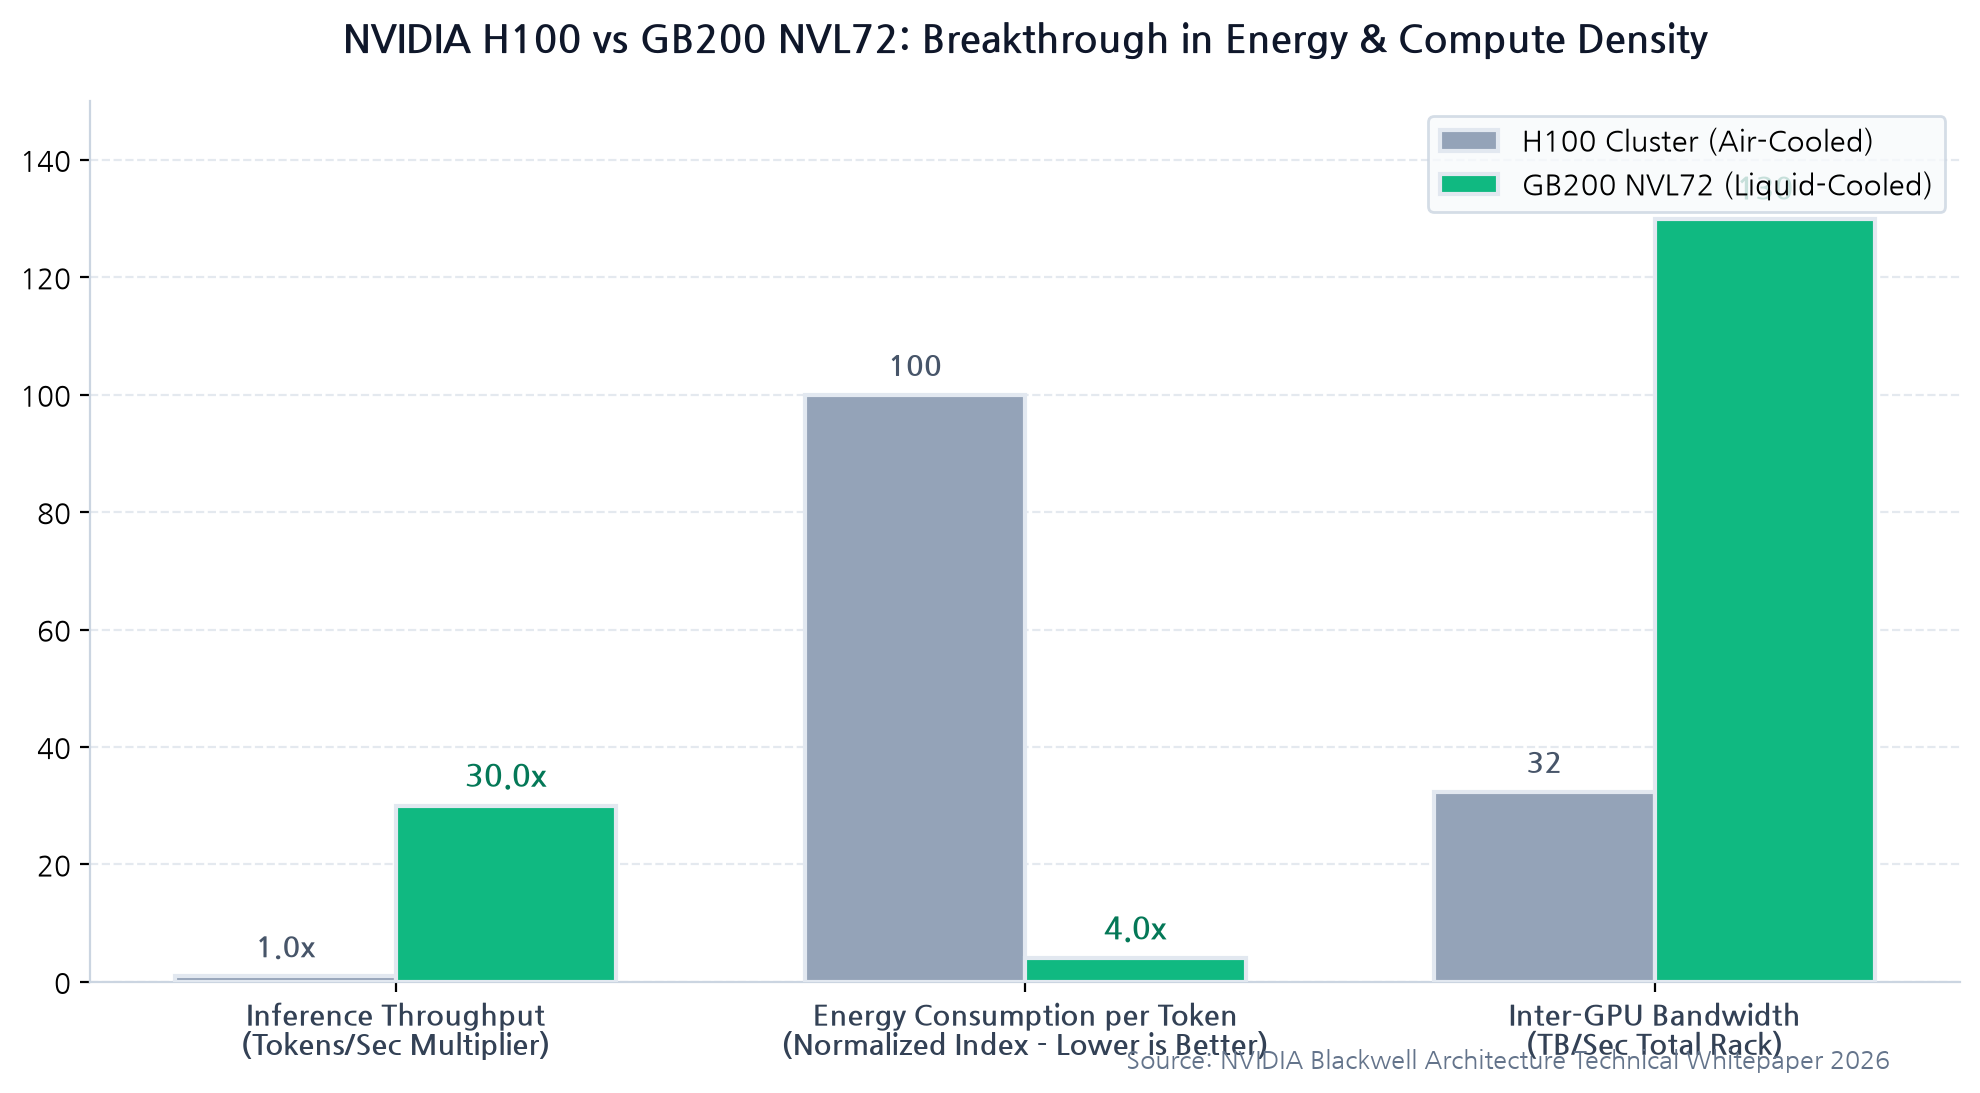
| TCOとエネルギー効率 | 前世代H100対比で推論性能が最大30倍、エネルギー消費を最大25倍削減。圧倒的なTCO削減効果で競合ASICの追随を遮断 |
| フルスタック独占の堀 | GPU単体ではなく、NVLinkスイッチ、NIC、液冷分配マニホールド、CUDA/cuDNN、vLLM最適化までを一体提供 |
| 構造的優位性 | NVIDIAは「半導体メーカー」から「AIデータセンターの発電・受電・冷却・計算を統括する総合プラットフォーマー」へ完全進化 |
世界のAI投資が過熱する中、生成AIの進化を規定する最大の制約要因が「計算アルゴリズム」から「電力と熱設計(Power & Thermal)」へと決定的な転換を迎えています。この地殻変動の震源地に立つのが、NVIDIAの次世代AI基盤「Blackwell(ブラックウェル)」アーキテクチャです。
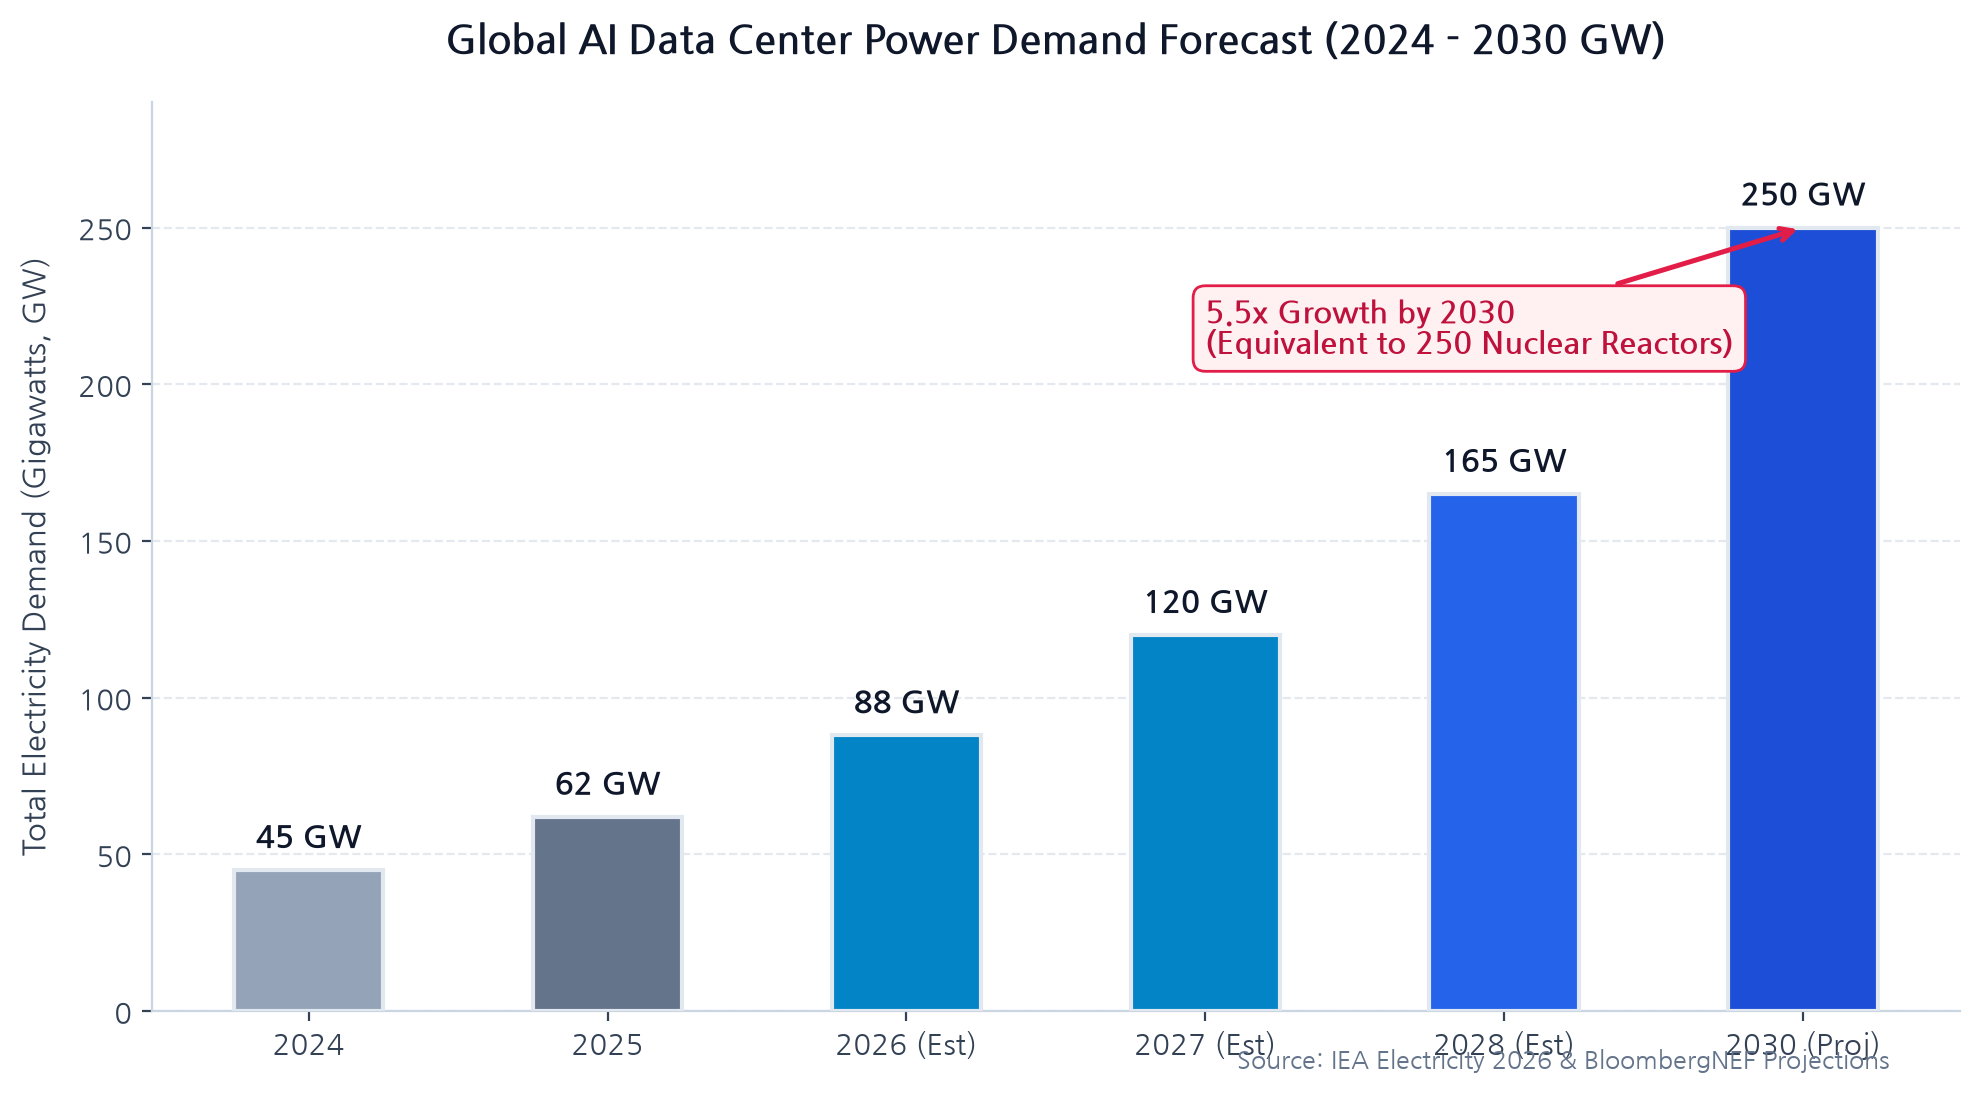
従来の「GPUサーバーを並べる」アプローチは限界を迎え、72基のBlackwell GPUと36基のGrace CPUを1つの巨大な液冷ラックに統合した「GB200 NVL72」は、1ラックあたり120kWという前代未聞の超高電力密度を誇ります。さらに、最新の巨大AIデータセンター単体で2.2GW〜7GW(原子力発電所2〜7基分)もの電力を必要とする時代が到来しました。
NVIDIAが単なる半導体チップ企業を超え、なぜ電力・冷却・ネットワークを垂直統合した「AIファクトリー」の支配者として君臨し続けるのか。SNSやエンジニアコミュニティで激論が交わされる最新データとともに、その構造的競争優位を徹底解剖します。
〜 1. Blackwell GB200 NVL72:1つの巨大GPUとして機能する「ラック型水冷コンピュータ」 〜
Blackwell世代において、NVIDIAが打ち出した最大のイノベーションは、チップ単体の性能向上にとどまらず、「ラック全体を1つの巨大なGPUとして再定義したこと」にあります。
2080億トランジスタと第5世代NVLinkの威力
Blackwell B200は、TSMCのカスタム4NPプロセスを採用し、2つのダイを10TB/sの極超高速リンクで接合した2080億トランジスタのモノリシック級チップです。
そして、これを72基束ねた「GB200 NVL72」は以下の圧倒的スペックを誇ります:
1. 毎秒1.8TBの全二重帯域(NVLink 5):72基のGPUがメモリ空間を完全に共有し、130TB/sという天文学的な総帯域幅を実現。
2. FP4高精度量子化エンジン:推論時の計算密度を倍増させ、数兆パラメータ規模の超巨大フロンティアモデルを単一ラック内で高速推論可能に。
3. 完全液体冷却(Direct-to-Chip Liquid Cooling):空気冷却の限界を超え、冷却液をチップのコールドプレートへ直接循環させることで冷却電力を劇的に削減。
「Blackwellは単なるチップではない。これは新しい産業革命を駆動するプラットフォームそのものである。」
— Jensen Huang (NVIDIA CEO, GTC Keynote)
〜 2. 「チップ不足」から「電力不足」へ:2.2GWデータセンターとエネルギー覇権 〜
現在、ウォール街やテクノロジー界隈で最も熱い議論を呼んでいるのが、「AIデータセンターが直面する絶望的な電力ボトルネック」です。
単一キャンパスで原発数基分:2.2GW〜7GWの衝撃
CNBCの最新調査レポートによれば、主要クラウド各社が建設を進める次世代AIデータセンターは、単一キャンパスで2.2GW(ギガワット)、2030年計画では7GW超という桁外れの電力を消費します。これは100万世帯以上の年間電力量に匹敵し、既存の送電網(Grid)だけでは供給が追いつきません。
このため、データセンター事業者は天然ガス火力発電所の買収や、原子力発電(SMR・次世代原子炉)との直結契約を急いでいます。
〜 3. TCO(総所有コスト)の経済学:なぜ競合ASICはNVIDIAに勝てないのか 〜
Google(TPU)、Amazon(Trainium)、Meta(MTIA)など、ビッグテック各社は自社製カスタムチップ(ASIC)の開発を加速させています。しかし、なぜNVIDIAのGPUシェアは依然として80%以上を維持し続けているのでしょうか。
圧倒的なエネルギー効率がもたらす経済的堀
その決定的な理由は、「エネルギー効率の差が、チップ開発費の差を完全に帳消しにしてしまうから」です。
GB200 NVL72は、前世代のH100クラスタと比較して、同一消費電力あたりの推論スループットを最大30倍、エネルギー消費量を最大25倍削減します。データセンターの電力供給が有限である以上、「限られたギガワット枠の中でどれだけ多くのトークンを生成できるか」がクラウド事業者の収益性を直撃します。
単にチップの単価を比較するのではなく、「消費電力1Wあたり何トークン生成できるか」というエネルギーTCOで比較した場合、自社ASICをゼロから開発・保守するよりも、NVIDIAの統合システムを導入する方が圧倒的に経済合理性が高いという結論に至ります。
〜 4. コミュニティとSNSが映す最新の論争点 〜
開発者コミュニティ(GitHub, Reddit, Hacker News)における生の声は、NVIDIAの強さと今後の課題を鮮明に浮き彫りにしています。
1. vLLM / 推論フレームワークの最適化競争:
GitHubの`vllm-project/vllm`や`flashinfer-ai`では、BlackwellのFP4テンソルコアに対応した分散推論PRが活発にマージされており、オープンソース開発コミュニティ全体がNVIDIAアーキテクチャを最優先にサポートしています。
2. TSMCへの供給集中リスク:
CoWoS(Chip-on-Wafer-on-Substrate)先端パッケージングのキャパシティがボトルネックであり続け、「TSMCが真の支配者である」という指摘も根強く存在します。
3. AIファクトリーの資産クラス化:
データセンターが単なるIT設備ではなく、トークンを連続生成する「21世紀の発電所・製鉄所」として不動産・エネルギー投資家から評価され始めています。
〜 総括:今後の展望と投資判断のポイント 〜
NVIDIAの強さを「半導体チップの設計力」だけで語る時代は完全に終わりました。
彼らが構築した真の堀(Moat)は、「TSMCの先端プロセス」→「液冷ラックの熱力学設計」→「NVLinkによるスイッチング」→「CUDA/cuDNNによるソフトウェア層」→「発電所直結のメガワット電力網」に至る、完全な「AIファクトリーの垂直統合」です。
競合が単体のGPUやASICを開発しても、120kWの液冷ラックと数万台規模の超低遅延クラスタを即座に量産・稼働させることは容易ではありません。AIのボトルネックが「電力」に移れば移るほど、エネルギー効率で他を圧倒するNVIDIAのプラットフォーム支配はより強固なものとなるでしょう。
※1: NVIDIA Corporation, NVIDIA Blackwell Architecture Technical Brief & Datasheet (公式技術仕様書)
※2: CNBC Industrial Documentary, Inside the Multi-Gigawatt AI Data Centers Powering Next-Gen AI (CNBC公式調査報道)
※3: International Energy Agency (IEA), Electricity 2026: Analysis and Forecast to 2030 – Data Center Growth (IEA世界電力分析)
※4: Tom’s Hardware, NVIDIA GB200 NVL72 Liquid Cooling Specifications and Thermal Analysis (熱設計分析)
※5: BloombergNEF, AI and Data Center Energy Outlook 2026: Behind-the-Meter Power Deals (BNEFエネルギーレポート)
※6: vLLM Project GitHub, FP4 Tensor Core Optimization and Distributed Inference Engine (OSS実装リポジトリ)
※7: Morgan Stanley Equity Research, Semiconductors: Blackwell Production Ramp and CoWoS Capacity Track (機関投資家レポート)

